

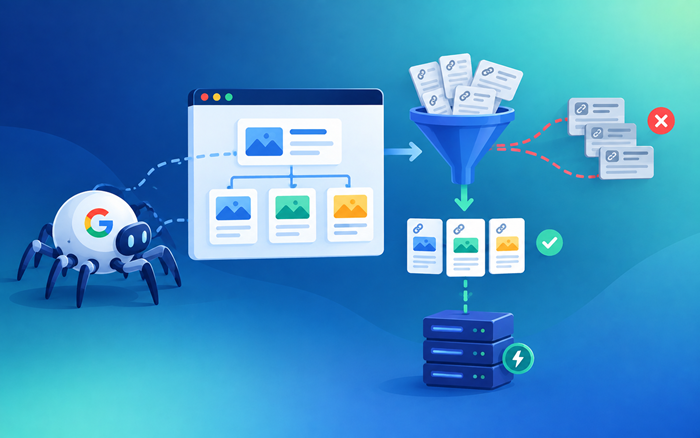
وقتی یک سایت را در گوگل ثبت می کنید، کار گوگل فقط به پیدا کردن صفحات و نمایش آن ها در نتایج جستجو ختم نمی شود. Googlebot باید دائماً صفحات سایت را کراول (Crawling) کند، تغییرات را تشخیص دهد و در صورت نیاز اطلاعات صفحات را دوباره پردازش کند.
اما گوگل منابع نامحدودی برای بررسی تمام URLهای وب ندارد. به همین دلیل، برای هر سایت میزان مشخصی از منابع را برای خزش در نظر می گیرد که در دنیای سئو با اصطلاح کراول باجت (Crawl Budget) یا بودجه خزش شناخته می شود.
مدیریت درست بودجه خزش به خصوص برای سایت های بزرگ، فروشگاه های اینترنتی، سایت های دارای صفحات زیاد و وب سایت هایی که مرتباً محتوای جدید منتشر می کنند اهمیت بیشتری دارد.
در این مقاله بررسی می کنیم کراول باجت چیست، چه عواملی روی آن تأثیر می گذارند و چگونه می توان خزش گوگل را در سایت بهینه کرد.
کراول باجت به مجموعه URLهایی گفته می شود که گوگل در یک سایت می تواند و می خواهد آن ها را crawl کند.
گوگل برای هر سایت نمی تواند بدون محدودیت درخواست ارسال کند؛ چون خزش بیش از حد ممکن است منابع سرور سایت را تحت فشار قرار دهد. از طرف دیگر، همه URLهای موجود در یک سایت نیز ارزش یکسانی برای خزش ندارند.
به همین دلیل گوگل بین دو مفهوم اصلی تعادل ایجاد می کند:
ظرفیت خزش (Crawl Capacity Limit) و تقاضای خزش (Crawl Demand) .
به زبان ساده می توان این طور تصور کرد:
بودجه خزش (Crawl Budget) به تعداد و میزان URLهایی گفته میشود که Googlebot با توجه به ظرفیت سرور و تقاضای خزش، میتواند و میخواهد در یک وبسایت بررسی کند.
این نکته بسیار مهم است؛ چون کراول باجت یک عدد ثابت و از پیش تعیین شده برای تمام سایت ها نیست.
خیر. طبق مستندات رسمی گوگل، موضوع Crawl Budget بیشتر برای سایت های بسیار بزرگ یا سایت هایی که تعداد زیادی URL دارند و محتوای آن ها مرتباً تغییر می کند اهمیت دارد.
گوگل به صورت تقریبی به این دسته ها اشاره می کند:
این اعداد صرفاً برای دسته بندی تقریبی هستند و آستانه های قطعی محسوب نمی شوند. گوگل همچنین می گوید اگر سایت شما تعداد صفحات بسیار زیادی ندارد و صفحات جدیدتان تقریباً همان روز یا مدت کوتاهی پس از انتشار crawl می شوند، معمولاً نیازی نیست بیش از حد درگیر مدیریت Crawl Budget شوید.
بنابراین اگر یک سایت وردپرسی ۵۰۰ صفحه ای دارید، نباید تصور کنید که صرفاً با افزایش Crawl Budget رتبه های بهتری خواهید گرفت.
یکی از اشتباهات رایج در بحث بودجه خزش، یکی دانستن Crawling و Indexing است.
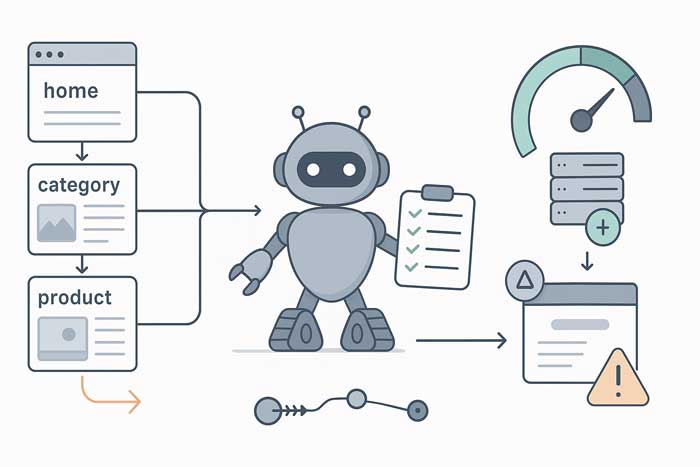
Crawling یعنی Googlebot به یک URL مراجعه می کند و محتوای آن را دریافت و بررسی می کند.
Indexing مرحله ای است که گوگل بعد از پردازش محتوا تصمیم می گیرد اطلاعات صفحه را برای استفاده در ایندکس جستجو نگهداری کند یا خیر.
بنابراین:
Crawled ≠ Indexed
ممکن است گوگل صفحه ای را crawl کند اما در نهایت آن را ایندکس نکند. گوگل بعد از خزش باید محتوا را بررسی، در صورت نیاز با URLهای دیگر تجمیع کند و درباره مناسب بودن آن برای ایندکس تصمیم بگیرد.
در نتیجه، افزایش Crawl Budget به تنهایی به معنی افزایش رتبه یا حتی ایندکس شدن تمام صفحات سایت نیست.
گوگل بودجه خزش سایت را با در نظر گرفتن دو مؤلفه اصلی تعیین می کند.
گوگل نمی خواهد Googlebot با ارسال درخواست های بیش از اندازه باعث اختلال در عملکرد سرور شما شود.
برای همین، سیستم های گوگل یک Crawl Capacity Limit در نظر می گیرند. این محدودیت به عواملی مانند تعداد ارتباطات هم زمان و مدت زمانی که سرور اتصال ها را باز نگه می دارد وابسته است.
اگر سرور سایت پایدار باشد و صفحات را سریع و بدون خطا پاسخ دهد، ظرفیت خزش می تواند در طول زمان افزایش پیدا کند.
در مقابل، اگر سرور مرتباً کند شود، زمان پاسخ افزایش پیدا کند یا خطاهای 5xx و محدودیت هایی مانند 429 ایجاد شود، گوگل ممکن است میزان خزش را کاهش دهد.
دومین عامل، میزان نیاز گوگل به خزش صفحات سایت است.
این تقاضا می تواند تحت تأثیر عوامل مختلفی قرار بگیرد؛ از جمله:
اندازه سایت: سایت های بزرگ تر URLهای بیشتری برای بررسی دارند.
دفعات تغییر محتوا: صفحاتی که مرتباً تغییر می کنند، ممکن است نیاز بیشتری به خزش مجدد داشته باشند.
محبوبیت URL : URLهایی که محبوبیت بیشتری دارند، ممکن است بیشتر crawl شوند تا اطلاعات آن ها تازه تر باقی بماند.
کیفیت و مرتبط بودن محتوا: گوگل در تعیین میزان منابع خزش، عوامل مرتبط با محصول خود مانند کیفیت کلی، ارزش کاربر و منحصر به فرد بودن محتوا را نیز در نظر می گیرد.
هدف از بهینه سازی Crawl Budget این نیست که گوگل را مجبور کنیم تعداد بیشتری درخواست به سایت ارسال کند. هدف اصلی این است که Googlebot زمان و منابع خود را صرف URL های ارزشمند کند، نه صفحات بی اهمیت و تکراری.
یکی از مهم ترین مواردی که می تواند بودجه خزش را هدر دهد، وجود تعداد زیادی URL با محتوای مشابه یا تکراری است.
برای مثال در یک فروشگاه اینترنتی ممکن است یک محصول از طریق URLهای متفاوتی در دسترس باشد:
example.com/product/shoes
example.com/product/shoes?color=black
example.com/product/shoes?sort=price
example.com/product/shoes?filter=size-42
اگر تعداد زیادی URL مشابه تولید شود، Googlebot ممکن است بخشی از منابع خود را صرف بررسی نسخه هایی کند که ارزش مستقلی ندارند.
بنابراین باید URLهای تکراری و پارامترهای غیرضروری را تا حد امکان مدیریت و در صورت نیاز URLهای مناسب را با روش های استاندارد Consolidate کرد.
اگر صفحاتی وجود دارند که نمی خواهید Googlebot آن ها را crawl کند، در شرایط مناسب می توانید از robots.txt استفاده کنید.
برای مثال ممکن است URLهای ناشی از فیلترها، مرتب سازی های مختلف یا بعضی صفحات تکراری ارزش خزش نداشته باشند.
نمونه:
User-agent: *
Disallow: /filter/
Disallow: /sort/
البته استفاده از robots.txt باید با دقت انجام شود. گوگل توصیه می کند از robots.txt برای مسدود کردن URLهایی که واقعاً نمی خواهید crawl شوند استفاده کنید، نه اینکه صرفاً برای مدت کوتاهی بخواهید بودجه خزش را به صفحات دیگر منتقل کنید.
robots.txt و noindex یکی نیستند! این تفاوت بسیار مهم است.
وقتی صفحه ای noindex دارد، Googlebot هنوز باید صفحه را درخواست کند تا بتواند دستور noindex را ببیند.
اما robots.txt می تواند جلوی crawl شدن URL را بگیرد.
بنابراین اگر هدف شما صرفاً جلوگیری از ایندکس است، انتخاب ابزار باید بر اساس سناریوی واقعی سایت انجام شود؛ و نباید تصور کرد noindex همان اثری را روی Crawl Budget دارد که جلوگیری از crawl با robots.txt دارد.
وقتی صفحه ای برای همیشه حذف شده و جایگزینی ندارد، بهتر است سرور پاسخ مناسب HTTP مانند:
404 Not Found
یا:
410 Gone
برگرداند.
طبق مستندات گوگل، پاسخ 404 سیگنال قدرتمندی برای این است که URL نباید دوباره به طور مکرر crawl شود.
در مقابل، اگر URL را فقط با robots.txt مسدود کنید، URL ممکن است مدت بیشتری در صف crawl باقی بماند و اگر محدودیت برداشته شود دوباره بررسی شود.
Soft 404 یکی دیگر از مشکلاتی است که می تواند باعث خزش غیرضروری شود.
در این حالت صفحه از نظر ظاهری شبیه یک صفحه ناموجود یا بدون محتواست، اما سرور به جای 404 واقعی، پاسخ 200 برمی گرداند.
برای مثال:
URL: example.com/product/not-found
HTTP Status: 200
در حالی که محتوای صفحه می گوید محصول پیدا نشد.
گوگل توصیه می کند Soft 404 ها شناسایی و برطرف شوند؛ زیرا این URLها همچنان ممکن است crawl شوند و منابع خزش را مصرف کنند.
Sitemap یکی از ساده ترین راه ها برای مشخص کردن URLهایی است که واقعاً می خواهید گوگل آن ها را بشناسد و crawl کند.
در Sitemap فقط صفحاتی را قرار دهید که:
اگر محتوای سایت مرتباً تغییر می کند، استفاده درست از تگ <lastmod> نیز می تواند به انتقال بهتر اطلاعات مربوط به آخرین تغییرات صفحات کمک کند.
یکی دیگر از مواردی که باید در بهینه سازی خزش بررسی شود، وجود Redirect Chain است.
مثلاً:
/page-a
↓
/page-b
↓
/page-c
↓
/page-d
اگر چندین ریدایرکت پشت سر هم ایجاد شده باشد، مسیر crawl پیچیده تر می شود و درخواست های بیشتری در فرایند انتقال URL درگیر خواهند شد.
تا جای ممکن، ریدایرکت را مستقیم تنظیم کنید:
/page-a
↓
/page-d
گوگل نیز توصیه می کند از زنجیره های طولانی ریدایرکت اجتناب شود.
این بخش برای مدیران سایت اهمیت زیادی دارد. سرعت سرور و کیفیت پاسخ گویی سایت می تواند روی ظرفیت خزش تأثیر بگذارد.
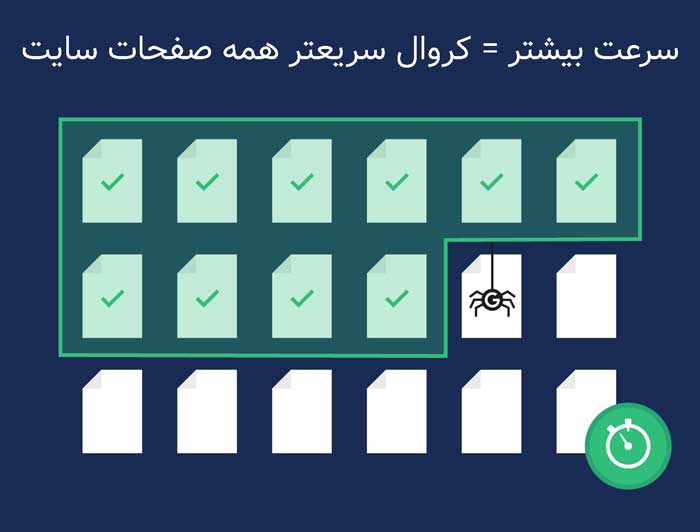
گوگل اعلام کرده است اگر سایت بتواند درخواست ها را به صورت پایدار و سریع پاسخ دهد، ظرفیت خزش می تواند افزایش پیدا کند. در مقابل، افزایش Latency یا زمان پاسخ، خطاهای xx5 و پاسخ های 429 می توانند باعث کاهش نرخ خزش شوند.
بنابراین وقتی درباره سرعت سایت صحبت می کنیم، موضوع فقط تجربه کاربر نیست.
سرعت پایین می تواند باعث شود:
سرور کند
↓
افزایش زمان پاسخ
↓
کاهش ظرفیت خزش
↓
درخواست های کمتر Googlebot
البته نباید این موضوع را به شکل ساده شده ای تفسیر کرد که (هاست سریع تر = بودجه خزش بیشتر = رتبه بهتر Crawl Budget) فقط یکی از بخش های سیستم خزش گوگل است و افزایش آن به خودی خود باعث افزایش رتبه نمی شود.
به صورت مستقیم نمی توان گفت خرید یک هاست خاص باعث افزایش Crawl Budget می شود.
اما اگر مشکل سایت از ظرفیت یا عملکرد سرور باشد، ارتقای منابع سرور می تواند به بهبود پاسخ گویی سایت کمک کند. گوگل نیز در مستندات رسمی خود صراحتاً اشاره می کند که اگر سایت به دلیل ظرفیت سرور قادر به crawl مناسب نباشد، افزایش منابع سرور می تواند یکی از راهکارها باشد. برای همین در سایت های بزرگ، انتخاب زیرساخت مناسب اهمیت بیشتری پیدا می کند.
اگر سایت شما با کندی سرور، زمان پاسخ بالا یا کمبود منابع مواجه است، بررسی یک زیرساخت مناسب می تواند بخشی از فرایند بهینه سازی فنی باشد. خرید هاست پرسرعت می تواند برای سایت هایی که به منابع پایدار و پاسخ گویی سریع تر سرور نیاز دارند، یکی از گزینه های قابل بررسی باشد.
برای بررسی وضعیت Crawl سایت، Google Search Console ابزارهای مختلفی در اختیار شما قرار می دهد.
یکی از مهم ترین بخش ها، Page Indexing است که می توانید در آن وضعیت URLهای سایت و دلایل ایندکس نشدن صفحات را بررسی کنید.
مواردی مانند:
Crawled – currently not indexed
Discovered – currently not indexed
Soft 404
Not found (404)
Server error (5xx)
می توانند در پیدا کردن مشکلات مربوط به ساختار URL، محتوا، پاسخ سرور و فرآیند خزش کمک کنند.
به خصوص اگر تعداد زیادی URL با وضعیت Discovered – currently not indexed دارید، بررسی ساختار سایت، کیفیت صفحات، لینک سازی داخلی، Sitemap و وضعیت سرور می تواند ارزشمند باشد. گوگل نیز این وضعیت را یکی از نشانه هایی می داند که ممکن است بررسی موضوع Crawl Budget را برای یک سایت منطقی تر کند.
لینک سازی داخلی یکی از بخش های مهم معماری سایت است.
وقتی صفحات مهم سایت از طریق لینک های داخلی مناسب به یکدیگر متصل باشند، Googlebot راحت تر می تواند مسیرهای مختلف سایت را پیدا و دنبال کند.
برای مثال:
صفحه اصلی
↓
دسته بندی
↓
مقاله
↓
صفحه محصول
یا در ساختار محتوایی:
Pillar
↓
Cluster Article
↓
Cluster Article
↓
Landing Page
لینک سازی داخلی به گوگل در کشف و درک رابطه میان صفحات کمک می کند؛ اما نباید آن را با افزایش مستقیم Crawl Budget یکی دانست.
هدف اصلی این است که مسیری منطقی برای کشف صفحات مهم سایت ایجاد شود.
این موضوع برای سایت های بزرگ بسیار مهم است. بسته به ساختار سایت، برخی URLها ممکن است ارزش خزش پایینی داشته باشند؛ برای مثال:
هرچه تعداد URLهای غیرضروری بیشتر باشد، احتمال اینکه بخشی از منابع Googlebot صرف آن ها شود نیز بیشتر می شود.
بنابراین یکی از مهم ترین اصول مدیریت بودجه خزش این است:
URLهای غیرضروری را کاهش دهید تا گوگل بتواند منابع خود را روی URLهای ارزشمندتر متمرکز کند.
نه به شکل مستقیم. هیچ دکمه ای در Google Search Console وجود ندارد که بتوانید با آن عدد Crawl Budget را به صورت دستی افزایش دهید.
بر اساس مستندات گوگل، اگر مشکل از ظرفیت سرور باشد، افزایش منابع سرور می تواند کمک کند. از طرف دیگر، کیفیت و ارزش محتوا، محبوبیت، منحصر به فرد بودن محتوا و ظرفیت سرویس دهی نیز در میزان منابع خزش نقش دارند. بنابراین رویکرد درست این نیست که صرفاً دنبال بیشتر کردن Crawl Budget باشید.
باید کاری کنید که:
URLهای غیرضروری کمتر شوند، صفحات مهم راحت تر پیدا شوند و سرور بتواند درخواست های Googlebot را پایدار و سریع پاسخ دهد.
برای یک بررسی فنی، این موارد را در سایت خود بررسی کنید:
| ردیف | موضوع بررسی | معیار بررسی |
| 1 | ساختار URL | آیا تعداد زیادی URL تکراری یا پارامتردار دارید؟ |
| 2 | Robots.txt | آیا صفحات غیرضروری واقعاً در صورت نیاز از crawl خارج شده اند؟ |
| 3 | 404 و 410 | آیا URLهای حذف شده پاسخ صحیح دریافت می کنند؟ |
| 4 | Soft 404 | آیا صفحات بدون محتوا با HTTP 200 پاسخ می دهند؟ |
| 5 | Sitemap | آیا Sitemap به روز است و فقط URLهای مهم را شامل می شود؟ |
| 6 | Redirect | آیا زنجیره های طولانی ریدایرکت در سایت وجود دارد؟ |
| 7 | سرور | آیا زمان پاسخ سرور بالا است؟ |
| 8 | خطاهای 5xx | آیا Googlebot با خطاهای سرور مواجه می شود؟ |
| 9 | HTTP 429 | آیا سرور در برخی شرایط درخواست ها را Rate Limit می کند؟ |
| 10 | لینک سازی داخلی | آیا صفحات مهم از طریق لینک های داخلی قابل کشف هستند؟ |
| 11 | Search Console | آیا بخش Page Indexing یا گزارش های مرتبط، الگوی غیرعادی در وضعیت URLها نشان می دهند؟ |
کراول باجت (Crawl Budget) یا بودجه خزش به میزان URLهایی اشاره دارد که گوگل بر اساس ظرفیت خزش و میزان تقاضای خزش، می تواند و می خواهد از یک سایت crawl کند.
این مفهوم برای تمام سایت ها وجود دارد، اما اهمیت آن برای سایت های بسیار بزرگ، سایت هایی با هزاران یا میلیون ها URL و وب سایت هایی که مرتباً به روزرسانی می شوند، بیشتر است.
برای بهینه سازی بودجه خزش، لازم نیست صرفاً به دنبال افزایش تعداد درخواست های Googlebot باشید. مهم تر این است که URLهای بی ارزش، صفحات تکراری، Soft 404ها، ریدایرکت های طولانی و مشکلات پاسخ گویی سرور را مدیریت کنید.
هم زمان، Sitemap را به روز نگه دارید، ساختار لینک های داخلی را منطقی کنید و مطمئن شوید زیرساخت سایت می تواند درخواست های موتور جستجو را با سرعت و پایداری مناسب پاسخ دهد.
در نهایت، یک نکته را فراموش نکنید: Crawl Budget با رتبه بندی یکسان نیست. افزایش خزش به تنهایی رتبه سایت را بالا نمی برد؛ بلکه هدف از بهینه سازی خزش این است که گوگل بتواند منابع خود را به شکل مؤثرتری برای کشف و پردازش محتوای سایت شما استفاده کند.
Crawl Budget یا بودجه خزش، مجموعه URLهایی است که گوگل با توجه به ظرفیت خزش و تقاضای خزش می تواند و می خواهد در یک سایت crawl کند.
Crawl Budget مستقیماً یک فاکتور رتبه بندی محسوب نمی شود، اما مدیریت صحیح آن می تواند در سایت های بزرگ به بهینه تر شدن فرآیند خزش و کشف محتوا کمک کند.
خیر. گوگل این موضوع را بیشتر برای سایت های بسیار بزرگ یا سایت هایی با تعداد زیاد URL و تغییرات مکرر مهم می داند. برای بسیاری از سایت های کوچک و متوسط، نگهداری Sitemap و بررسی منظم وضعیت ایندکس کافی است.
عملکرد سرور می تواند روی Crawl Capacity تأثیر داشته باشد. افزایش زمان پاسخ، خطاهای 5xx یا پاسخ های 429 می تواند باعث شود گوگل میزان crawl را کاهش دهد.
برای جلوگیری از crawl شدن URLهایی که واقعاً نمی خواهید Googlebot آن ها را بررسی کند، robots.txt می تواند مناسب باشد. با این حال، گوگل توصیه می کند از آن به عنوان روشی موقت برای انتقال بودجه خزش از یک بخش سایت به بخش دیگر استفاده نشود.
Crawl به فرایند دسترسی و دریافت صفحه توسط Googlebot گفته می شود، در حالی که Indexing مرحله پردازش و ارزیابی صفحه برای حضور در ایندکس گوگل است. بنابراین crawl شدن یک URL تضمین نمی کند که آن URL حتماً ایندکس شود.
منبع: https://developers.google.com/crawling/docs/crawl-budget